Originally published at braginskyoleg.com.
Какая механика заложена в основу работы архиваторов? Простое сокращение подобных или витиеватое волшебство чисел, доступное техномагам. Основатель «Школы Траблшутеров» Олег Брагинский и ученик Максим Голубь разбирают сжатие данных по косточкам.
Алгоритм базовой упаковки предложил студент Массачусетского Технологического Института Дэвид Хаффман (1925-1999 г.). Появлением он обязан выбору, который поставил перед группой профессор Роберт Фано: сдавать экзамен, либо защитить диссертацию на предложенную тему.
Хаффман выбрал защиту, и преподаватель обозначил задачу, которой давно занимался сам: оптимальное кодирование информации. Найдя решение, Дэвид получил зачёт и превзошёл учителя, предложив решение открытой проблемы, ставшее основой для сжатия данных.
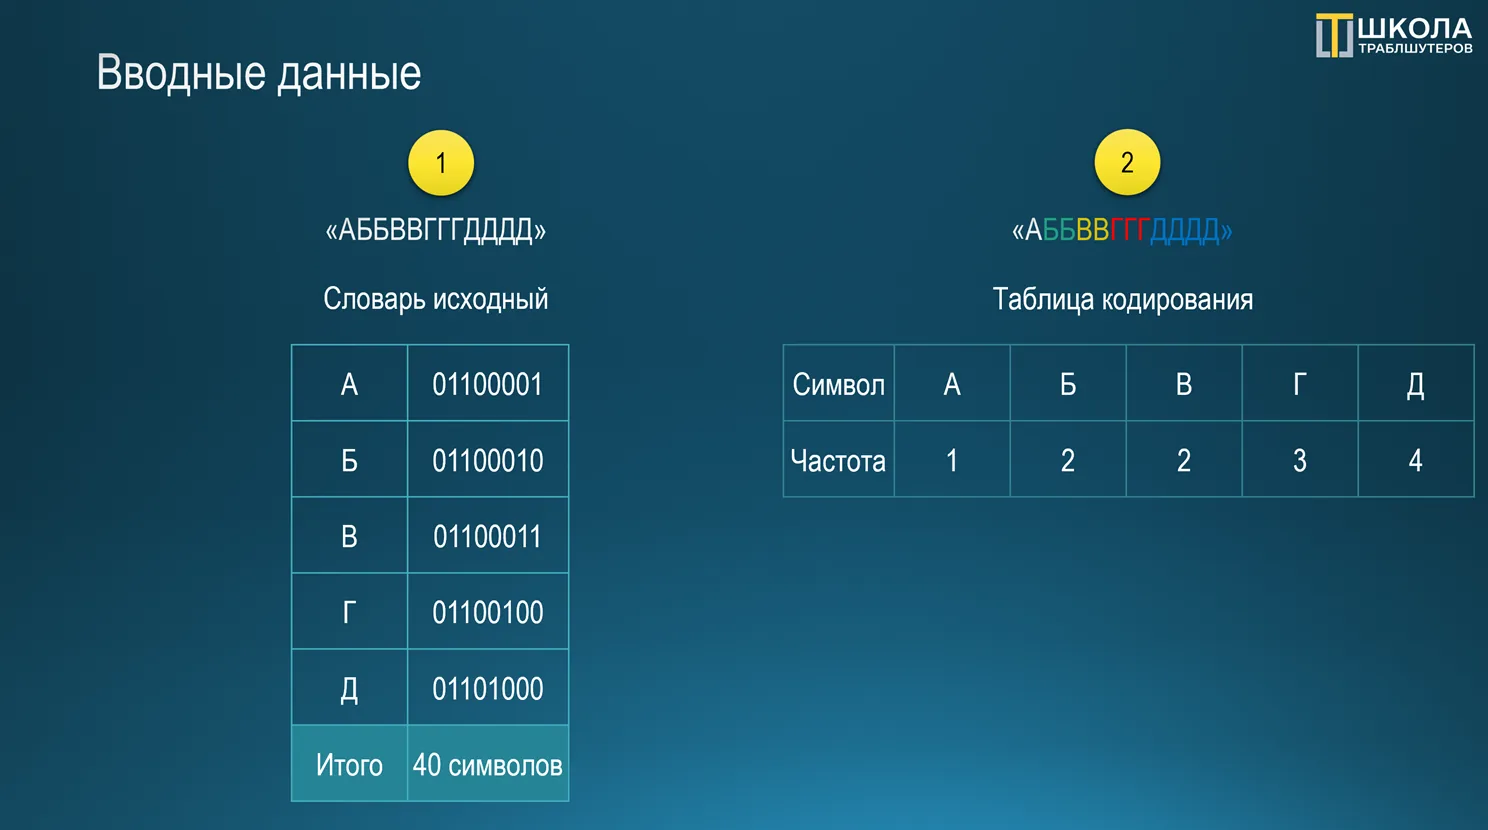
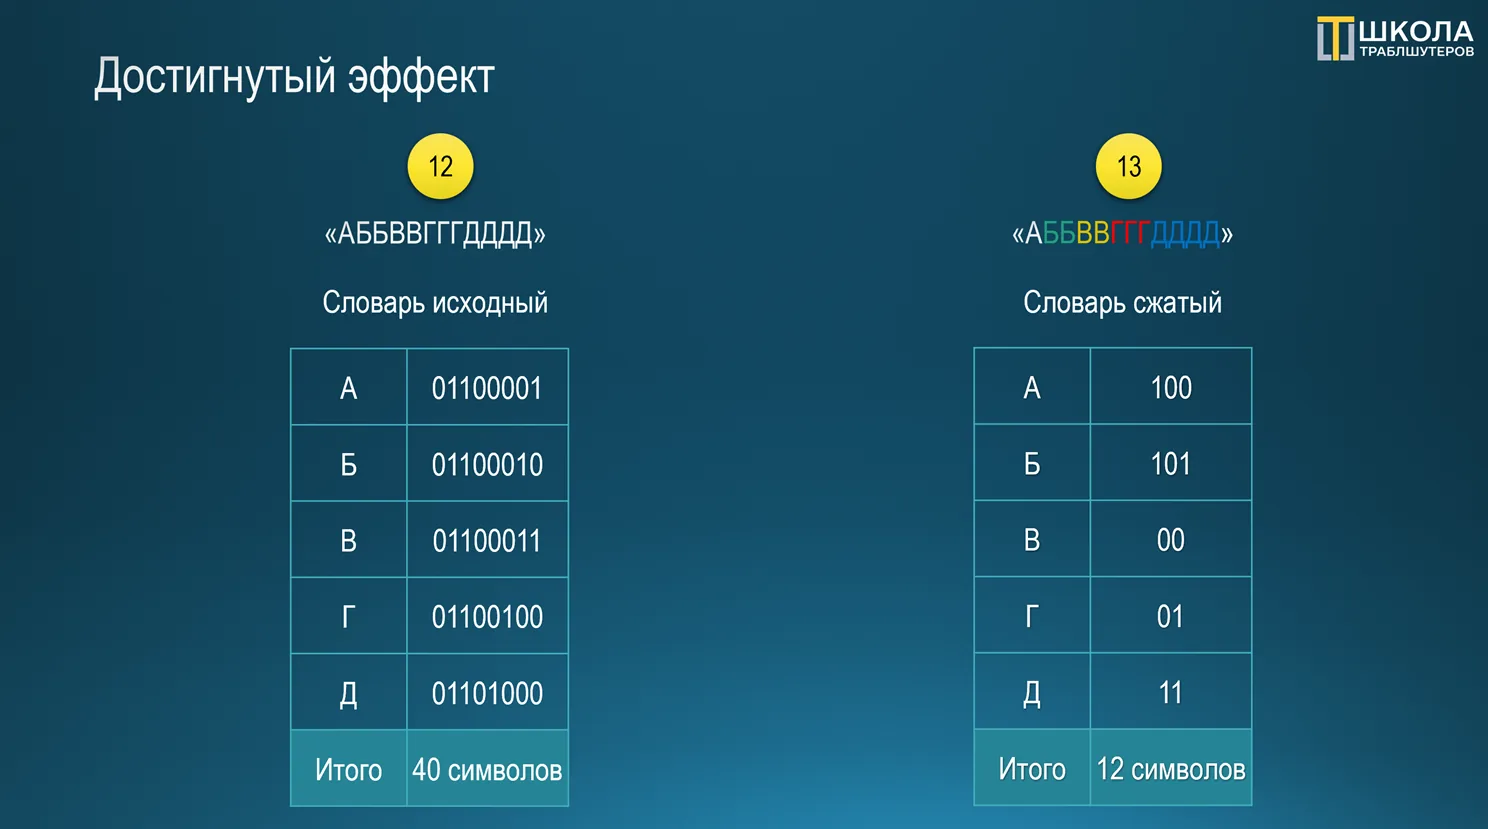
Предположим, что на входе есть строка вида: «АББВВГГГДДДД». Чтобы закодировать последовательность в неизменном виде понадобится словарь из пяти значений, на каждое из которых придётся по восемь байт. Итого получим 40 бит для хранения набора информации.
Наша задача построить дерево, пройдя по веткам которого, получим более короткий код искомого элемента. Значения расположим так, чтобы редко встречающиеся блоки получили более длинный шифр, а мелькающим часто вручим короткий номер. Построение проведём от веток к основанию.
Для исходной строки (1) составим полный список уникальных символов. Посчитаем частоту встречаемости в значениях. Получим: «А» встречается единожды, «Б» и «В» можно увидеть два раза, «Д» появляется в трёх местах, а «Г» как квартет музыкантов играет партию на четверых (2).
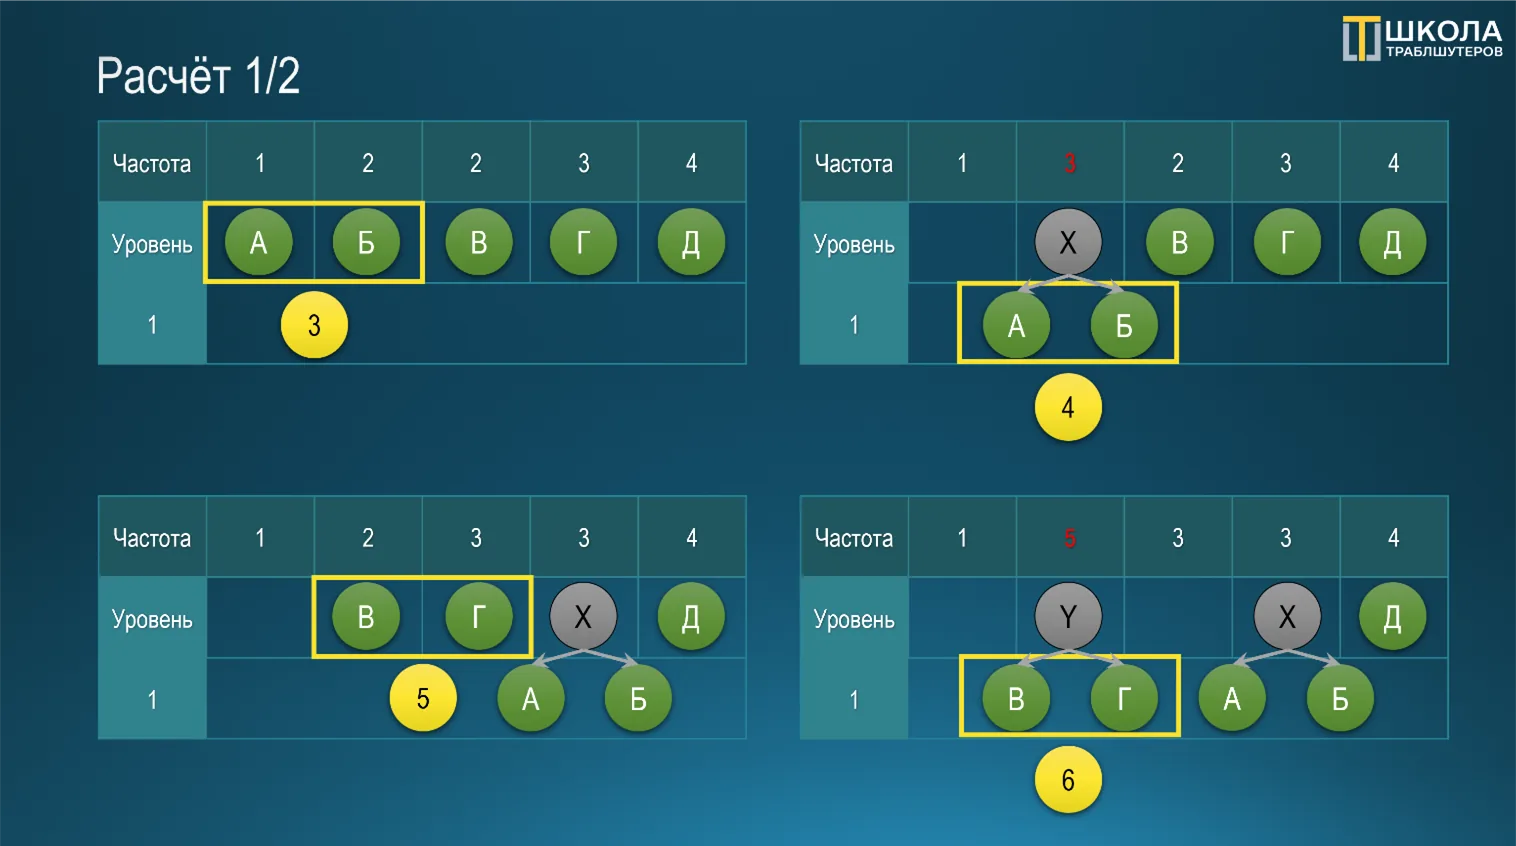
Отсортируем таблицу по возрастанию частоты встречаемости. Далее объединим два первых элемента между собой (3). Получившаяся конструкция станет родителем и получит имя «Х». Просуммируем для него частоты символов «А» и «Б»: получим значение равное трём (4).
Так как X имеет более высокое значение чем соседняя «В» равная двойке, то переместим его вправо, чтобы сохранить порядок сортировки. Для «В» и «Г» применим такое же правило группировки (5), получим узел равный пяти (6). Присвоим ему имя «Y» и перенесём в конец ряда.
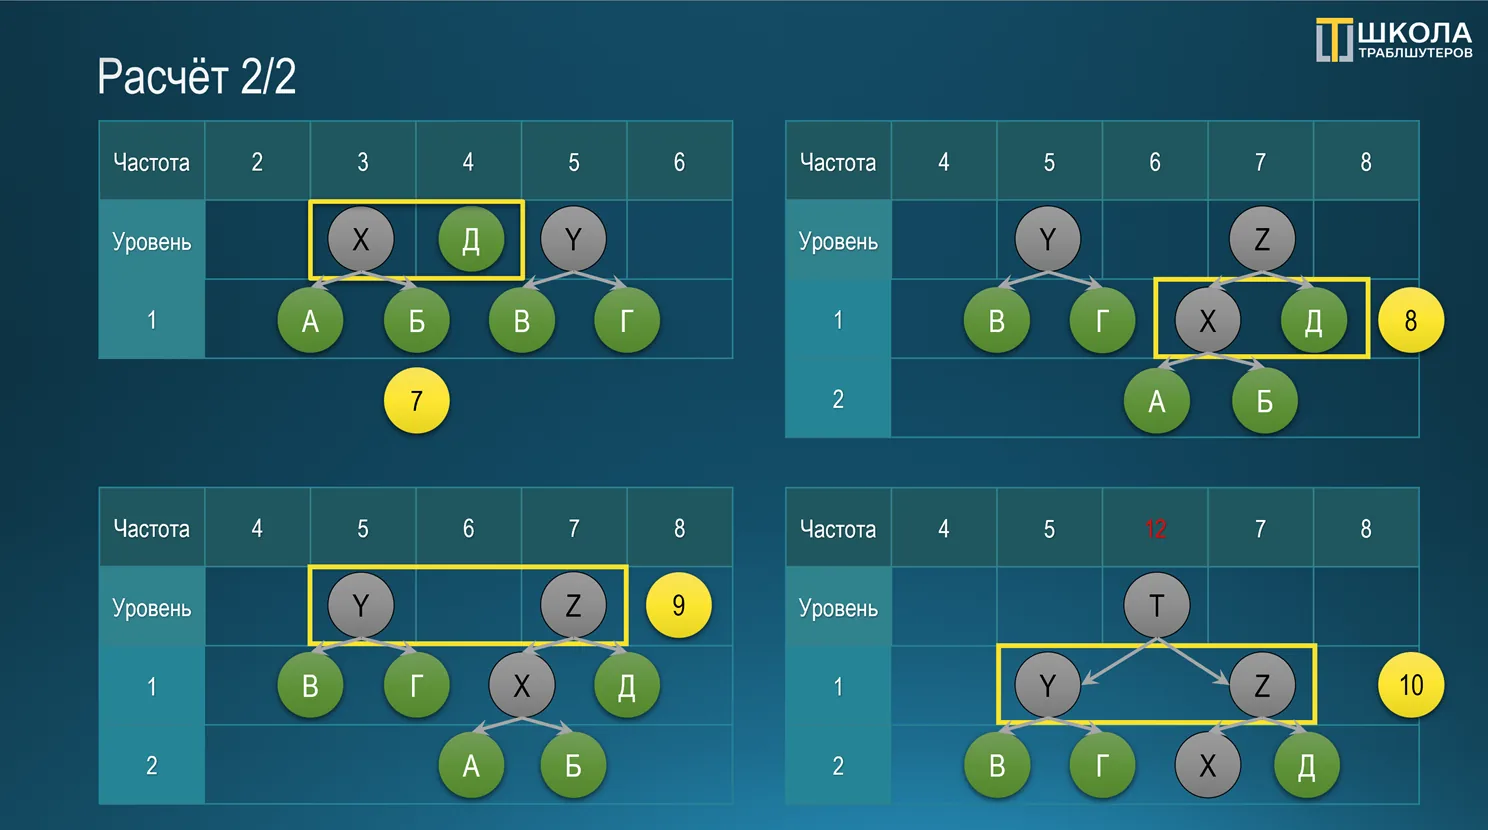
Продолжим объединение для «X» и «Д» (7). Так как «Х» уже имеет под собой два дочерних элемента, то вместе с «Д» они образуют новый уровень, назовём его «Z» (8). Последний шаг, объединение «Y» и «Z». Наречём получившийся элемент литерой «T» (10).
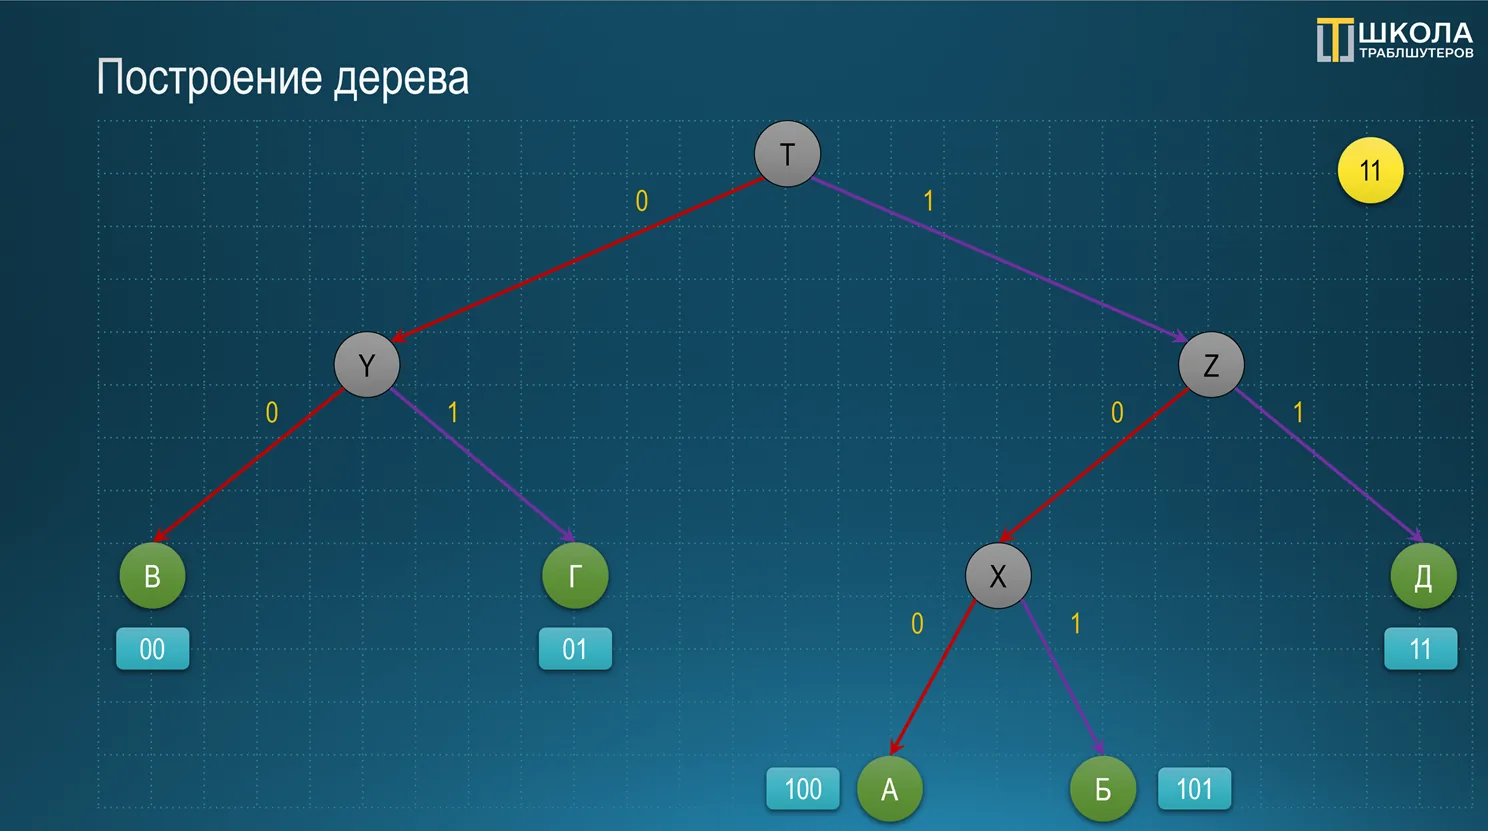
В дереве объектов закодируем каждый элемент, проложив к нему цифровой путь. Зададим правило: если движемся от вершины по ребру влево, то значение этапа равно нулю, движение вправо: единице. При прохождении узла добавляем цифру к итоговому значению (11).
Пробежим по каждой ветке, запишем код всех значений. «X», «Y», «Z» и «T» пропускаем, являются объединяющими узлами и их судьба для нас не важна. Обратите внимание, что до частых элементов «добираемся» быстрее, а путь к редким требует нескольких переходов.
Запишем полученные значения в итоговую таблицу и сравним с исходным словарём. При изначальных сорока битах (12) получили новый легковесный словарь с набором из двенадцати (13), что даёт экономию в двадцать восемь знаков, сохраняя драгоценное место в объёме 70%.
Алгоритм Дэвида Хаффмана был разработан в середине пятидесятых годов. Благодаря простоте и постоянной выдаче оптимальных результатов взят за основу решений, требующих сжатия данных при кодировании и передачи информации во множестве программ и устройств.